
Dois meses até o fim do suporte ao PostgreSQL 14: pratique a recuperação antes do upgrade
Algumas equipes já definiram o cronograma para atualizar a versão do banco de dados, mas não sabem quanto tempo levará para fazer o rollback em caso de falha. Se você opera o PostgreSQL 14, a entrega necessária agora não é apenas o nome de uma nova versão, mas um plano de transição que permita a recuperação. Em 14 de setembro de 2026, restam cerca de dois meses até a data oficial de encerramento do suporte.
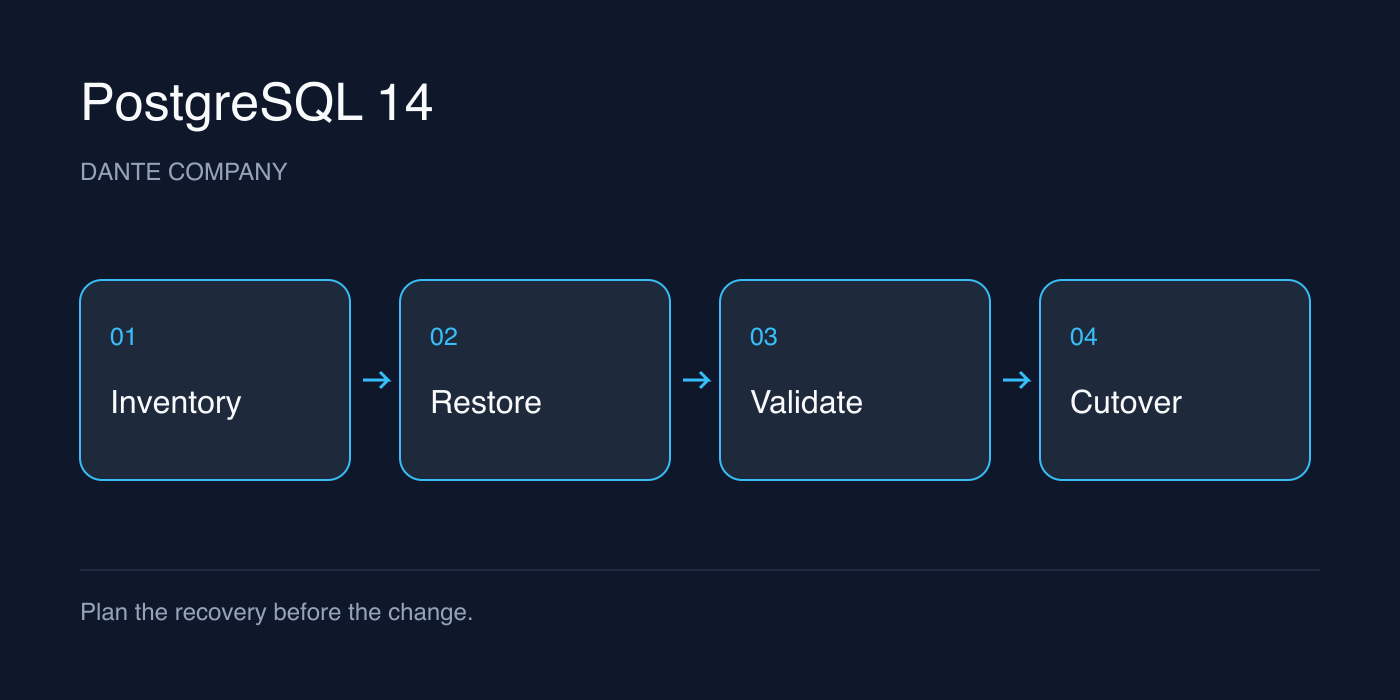
Fatos confirmados: suporte da comunidade e contratos de hospedagem são diferentes
A política oficial de versionamento do PostgreSQL prevê suporte a versões principais (major) por cinco anos e define a data da última versão do 14 como 12 de novembro de 2026. Esse é o cronograma de suporte da comunidade. Janelas de upgrade em serviços gerenciados, suporte estendido específico e tarifas devem ser verificados separadamente na documentação e no contrato do respectivo provedor.
Também é preciso distinguir atualizações secundárias (minor) dentro da mesma versão principal de upgrades principais (major). Aplicar a versão de correção mais recente do 14 não substitui a migração para o 15 ou superior. Por outro lado, adiar continuamente correções necessárias na versão atual apenas por planejar uma migração major tampouco é adequado.
Primeiro entregável: lista de dependências antes do tamanho dos dados
A partir daqui, tratam-se de sugestões operacionais práticas, e não da política de suporte oficial em si. Primeiro, documente em uma única página a versão do banco por serviço, extensões e versões, drivers de conexão, jobs em lote (batch), locais de armazenamento de backup e configuração de replicação. Não escolha a versão de destino apenas por ser a mais recente; verifique também o ambiente de hospedagem real e o escopo de suporte das extensões.
Assumir que a transição será rápida só porque a base de dados é pequena não é suficiente. Se extensões ou consultas usadas em fluxos essenciais de negócios — como a primeira consulta após o login ou a atualização do status de pagamento — mudarem de comportamento, a transição pode falhar, mesmo que a cópia de dados leve pouco tempo. O objetivo desta lista é encontrar dependências que não possuem um responsável definido.
Segundo entregável: resultados de restauração em vez de mensagens de backup concluído com sucesso
Restaure um backup recente em um ambiente isolado e execute os principais fluxos de leitura e escrita da aplicação. Nesse exercício, verifique primeiro o destino da conexão para garantir que nenhuma escrita seja enviada ao banco de produção. Cópias restauradas contendo dados reais devem ser tratadas dentro do escopo dos controles de acesso existentes.
Separar o horário de início do backup, o horário de conclusão da restauração e o horário de validação evita confundir o tempo necessário para obter os arquivos com o tempo em que o serviço volta a aceitar escritas. Em vez de aprovar apenas pequenas amostras artificialmente rápidas, meça o tempo com uma restauração próxima do tamanho de produção e registre também as restrições de custo e espaço em disco.
Passar na verificação do pg_upgrade não substitui a validação do serviço
A documentação oficial do pg_upgrade explica que a opção --check permite realizar verificações de compatibilidade antes do upgrade real. A compatibilidade de módulos externos deve ser examinada separadamente, e bibliotecas compartilhadas adequadas ao novo servidor também são necessárias. Não interprete o sucesso do comando de verificação como prova de que todas as consultas e a performance da aplicação já foram validadas.
Em particular, o modo --link tem a restrição de que, após iniciar o novo cluster, o cluster antigo não poderá mais ser utilizado como estava. Se você escolher o método focando apenas na velocidade, o caminho de reversão planejado pode desaparecer. Ensaye sob condições idênticas às da migração real e defina com clareza o momento em que um retorno baseado em restauração se faz necessário.
Critérios a serem definidos antes de retomar as gravações
Defina os critérios de sucesso com antecedência para não precisar improvisar acordos no dia da migração. Por exemplo, você pode vincular responsáveis à conclusão de leituras e escritas das principais APIs, à retomada dos jobs em lote sem processamento duplicado, à consistência de agregações de negócios em tabelas centrais e à verificação do status de replicação. Este exemplo não visa impor os mesmos valores de referência a todos os serviços.
Se a escrita for iniciada no novo banco de dados e for necessário retornar ao backup anterior, a preservação das alterações feitas nesse intervalo se torna um problema. Não trate o simples procedimento de ligar o servidor antigo como equivalente a reverter sem perda de dados. O escopo aceitável de perda de dados e tempo de inatividade deve ser acordado pelos responsáveis pelo serviço.
O que fazer esta semana e contrapontos
Se for difícil migrar todos os bancos de dados de uma só vez, meça o tempo de restauração, validação e reversão em um único serviço com menos dependências e use os resultados como subsídio para planejar os outros serviços. Reunir responsáveis, datas candidatas à migração e critérios de cancelamento em caso de falha de validação em um único documento transforma um projeto que só tem prazos em tarefas executáveis.
É compreensível o argumento de que o desenvolvimento de produtos é mais urgente no momento. Contudo, manter-se sem saber como recuperar o sistema até a data limite reduz as janelas de verificação disponíveis. Este artigo não defende ganhos de performance de uma versão específica nem reflete a opinião de toda a comunidade. Trata-se de uma proposta operacional focada na preparação para lidar com falhas de migração, em vez da pressa para adotar os recursos mais recentes.