
เหลือเวลาอีกสองเดือนก่อน PostgreSQL 14 สิ้นสุดการสนับสนุน: ซ้อมกู้คืนระบบก่อนคิดเรื่องอัปเกรด
มีหลายทีมที่กำหนดวันอัปเกรดเวอร์ชันฐานข้อมูลไว้แล้ว แต่กลับไม่รู้ว่าหากเกิดความล้มเหลวจะต้องใช้เวลานานแค่ไหนในการย้อนกลับ หากคุณกำลังดูแล PostgreSQL 14 อยู่ สิ่งที่ต้องส่งมอบในตอนนี้ไม่ใช่แค่ชื่อเวอร์ชันใหม่ แต่เป็นแผนการเปลี่ยนผ่านที่สามารถกู้คืนได้จริง ณ วันที่ 14 กันยายน 2026 เหลือเวลาอีกประมาณสองเดือนก่อนจะถึงวันสิ้นสุดการสนับสนุนอย่างเป็นทางการ
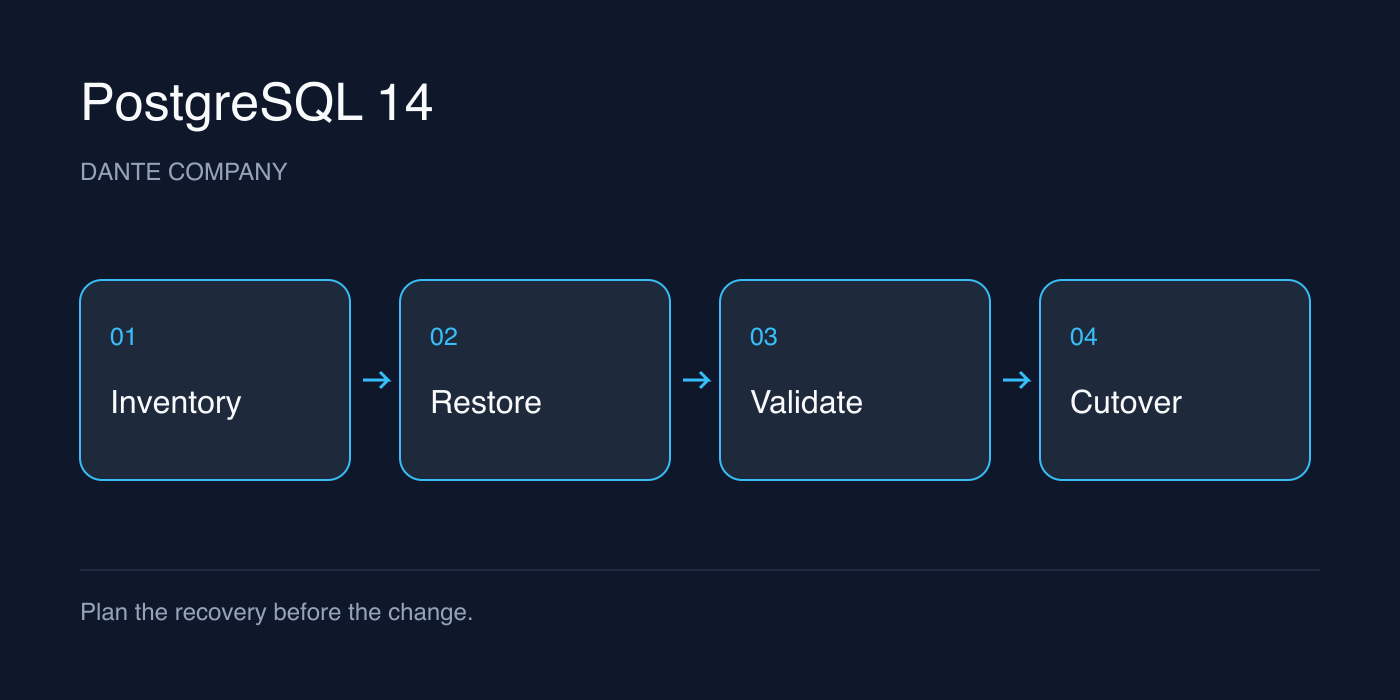
ข้อเท็จจริงที่ได้รับการยืนยัน: การสนับสนุนจากชุมชนกับสัญญาโฮสติ้งเป็นคนละเรื่องกัน
นโยบายเวอร์ชันอย่างเป็นทางการของ PostgreSQL จะสนับสนุนเวอร์ชันหลัก (Major version) เป็นเวลา 5 ปี และระบุวันปล่อยอัปเดตสุดท้ายของเวอร์ชัน 14 ไว้เป็นวันที่ 12 พฤศจิกายน 2026 นี่คือกำหนดการสนับสนุนของชุมชน สำหรับช่วงเวลาอัปเกรด (upgrade window), การขยายเวลาสนับสนุนเพิ่มเติม และค่าบริการของบริการแบบ Managed Service คุณต้องตรวจสอบแยกต่างหากจากเอกสารและสัญญาของผู้ให้บริการแต่ละราย
คุณต้องแยกแยะระหว่างการอัปเดตย่อย (Minor update) ในเวอร์ชันหลักเดิมกับการอัปเกรดเวอร์ชันหลัก การติดตั้งเวอร์ชันแก้ไขล่าสุดของ 14 ไม่สามารถทดแทนการย้ายไปยังเวอร์ชัน 15 ขึ้นไปได้ ในทางกลับกัน การผัดวันประกันพรุ่งไม่ยอมติดตั้งตัวแก้ไขที่จำเป็นในเวอร์ชันปัจจุบัน เพียงเพราะมีแผนจะอัปเกรดเวอร์ชันหลักอยู่แล้ว ก็เป็นสิ่งที่ไม่ถูกต้องเช่นกัน
ผลงานชิ้นแรก: รายการสิ่งที่ระบบต้องพึ่งพา สำคัญกว่าขนาดข้อมูล
เนื้อหาต่อจากนี้เป็นข้อเสนอแนะในการปฏิบัติงานจริง ไม่ใช่นโยบายสนับสนุนอย่างเป็นทางการ ขั้นแรก ให้รวบรวมข้อมูลลงในเอกสารหน้าเดียว ได้แก่ เวอร์ชันของ DB แต่ละบริการ, ส่วนขยาย (extensions) และเวอร์ชันที่ใช้, ไดรเวอร์การเชื่อมต่อ, งานประมวลผลแบบแบตช์ (batch jobs), ตำแหน่งจัดเก็บไฟล์สำรองข้อมูล และโครงสร้างการทำ Replication อย่าเลือกเวอร์ชันเป้าหมายเพียงเพราะเป็นเวอร์ชันใหม่ล่าสุด แต่ให้ตรวจสอบขอบเขตการรองรับของสภาพแวดล้อมโฮสติ้งจริงและส่วนขยายไปพร้อมกัน
การสันนิษฐานว่าฐานข้อมูลมีขนาดเล็กแล้วจะทำงานได้เร็วเสมอไปนั้นยังไม่เพียงพอ หากส่วนขยายหรือคิวรีที่ใช้งานในเส้นทางสำคัญทางธุรกิจ เช่น การดึงข้อมูลครั้งแรกหลังเข้าสู่ระบบ หรือการอัปเดตสถานะการชำระเงิน มีพฤติกรรมเปลี่ยนไป แม้ระยะเวลาคัดลอกข้อมูลจะสั้น การย้ายระบบก็อาจล้มเหลวได้ วัตถุประสงค์ของรายการนี้คือการค้นหาการพึ่งพา (dependencies) ที่ไม่มีผู้รับผิดชอบดูแล
ผลงานชิ้นที่สอง: ผลลัพธ์จากการกู้คืน แทนที่จะดูแค่ข้อความว่าสำรองข้อมูลสำเร็จ
ให้กู้คืนข้อมูลสำรองล่าสุดในสภาพแวดล้อมที่แยกต่างหาก แล้วรันโฟลว์การอ่านและการเขียนที่เป็นตัวแทนของแอปพลิเคชัน ในการซ้อมนี้ ต้องตรวจสอบปลายทางการเชื่อมต่อเป็นอันดับแรกเพื่อป้องกันไม่ให้ส่งคำสั่งเขียนไปยัง DB ใช้งานจริง (Production) ส่วนข้อมูลสำรองที่มีข้อมูลจริงอยู่จะต้องจัดการภายใต้ขอบเขตการควบคุมการเข้าถึงเดิม
การแยกบันทึกเวลาเริ่มต้นสำรองข้อมูล, เวลาที่กู้คืนเสร็จสิ้น และเวลาที่ตรวจสอบเสร็จสิ้น จะช่วยป้องกันความสับสนระหว่างเวลาที่ใช้ดึงไฟล์กับเวลาที่ระบบพร้อมกลับมารับคำสั่งเขียนได้อีกครั้ง แทนที่จะทดสอบผ่านเฉพาะตัวอย่างข้อมูลขนาดเล็กที่เร็วกว่าความเป็นจริง ให้วัดเวลาโดยใช้ข้อมูลสำรองที่มีขนาดใกล้เคียงกับ Production จริง พร้อมทั้งบันทึกข้อจำกัดด้านค่าใช้จ่ายและพื้นที่จัดเก็บด้วย
การผ่านการตรวจสอบของ pg_upgrade ไม่ได้แปลว่าระบบทำงานได้จริง
เอกสารทางการของ pg_upgrade อธิบายว่าสามารถใช้ตัวเลือก --check เพื่อตรวจสอบความเข้ากันได้ก่อนทำการอัปเกรดจริง ความเข้ากันได้ของโมดูลภายนอกต้องได้รับการตรวจสอบแยกต่างหาก และจำเป็นต้องมี shared library ที่ตรงกับเซิร์ฟเวอร์ใหม่ด้วย อย่าด่วนสรุปว่าคิวรีและประสิทธิภาพของแอปพลิเคชันได้รับการตรวจสอบครบถ้วนแล้ว เพียงเพราะคำสั่งตรวจสอบทำงานผ่าน
โดยเฉพาะอย่างยิ่ง วิธี --link มีข้อจำกัดตรงที่ไม่สามารถกลับไปใช้คลัสเตอร์เดิมได้อีกหลังจากเริ่มใช้งานคลัสเตอร์ใหม่ หากเลือกวิธีนี้โดยดูแค่เรื่องความเร็ว อาจทำให้เส้นทางการย้อนกลับ (rollback) ที่คาดการณ์ไว้หายไปได้ คุณต้องซักซ้อมภายใต้เงื่อนไขเดียวกันกับวิธีการเปลี่ยนผ่านจริง และระบุจุดเวลาที่จำเป็นต้องตัดสินใจย้อนกลับด้วยการกู้คืนข้อมูลให้ชัดเจน
เกณฑ์ที่ต้องตัดสินใจก่อนกลับมาเปิดรับการเขียนข้อมูล
ควรกำหนดเกณฑ์ความสำเร็จไว้ล่วงหน้าเพื่อหลีกเลี่ยงการมานั่งตกลงกันหน้างานในวันเปลี่ยนผ่าน ตัวอย่างเช่น สามารถกำหนดผู้รับผิดชอบร่วมกับเกณฑ์ต่างๆ เช่น การอ่านและเขียนของ API สำคัญทำงานสมบูรณ์, งานประมวลผลแบบแบตช์ทำงานต่อได้โดยไม่มีการประมวลผลซ้ำซ้อน, ตัวเลขสรุปทางธุรกิจของตารางหลักตรงกัน และสถานะการทำ Replication เป็นปกติ นี่ไม่ใช่ตัวอย่างเพื่อบังคับใช้เกณฑ์มาตรฐานเดียวกันกับทุกบริการ
หลังจากเริ่มรับการเขียนบน DB ตัวใหม่แล้ว หากต้องย้อนกลับไปใช้ข้อมูลสำรองเดิม ปัญหาคือจะเก็บรักษาความเปลี่ยนแปลงที่เกิดขึ้นระหว่างนั้นอย่างไร ไม่ควรมองว่าขั้นตอนเพียงแค่เปิดเซิร์ฟเวอร์เดิมขึ้นมาใหม่เหมือนกับขั้นตอนการย้อนกลับโดยไม่มีข้อมูลสูญหาย ขอบเขตความสูญเสียและระยะเวลาหยุดทำงานที่ยอมรับได้จะต้องผ่านการเห็นชอบจากผู้รับผิดชอบบริการ
สิ่งที่ต้องทำในสัปดาห์นี้และข้อโต้แย้ง
หากเป็นเรื่องยากที่จะย้าย DB ทั้งหมดในคราวเดียว ให้เลือกบริการหนึ่งที่มีการพึ่งพาน้อยที่สุดมาวัดเวลากู้คืน ตรวจสอบ และย้อนกลับ แล้วนำผลลัพธ์นั้นไปใช้เป็นข้อมูลตั้งต้นสำหรับวางแผนบริการอื่นๆ เมื่อรวบรวมผู้รับผิดชอบ, วันที่มีแนวโน้มจะเปลี่ยนผ่าน และเกณฑ์การยกเลิกกรณีการตรวจสอบล้มเหลวไว้ในเอกสารฉบับเดียว โปรเจกต์ที่มีแต่กำหนดการก็จะเปลี่ยนเป็นงานที่สามารถลงมือปฏิบัติได้จริง
ข้อโต้แย้งที่ว่าการพัฒนาผลิตภัณฑ์มีความเร่งด่วนมากกว่าในตอนนี้เป็นเรื่องที่เข้าใจได้ อย่างไรก็ตาม หากปล่อยให้ตนเองไม่รู้วิธีกู้คืนระบบไปจนถึงช่วงใกล้เส้นตาย เวลาที่สามารถเลือกใช้ตรวจสอบระบบก็จะยิ่งลดน้อยลง บทความนี้ไม่ได้มุ่งเน้นอวดอ้างเรื่องประสิทธิภาพที่เพิ่มขึ้นของเวอร์ชันใดเวอร์ชันหนึ่ง หรือเป็นตัวแทนความคิดเห็นทั้งหมดของชุมชน แต่เป็นข้อเสนอแนะเชิงปฏิบัติที่มุ่งเน้นความพร้อมในการรับมือกับความล้มเหลวของการเปลี่ยนผ่าน มากกว่าความเร็วในการนำฟีเจอร์ใหม่มาใช้